这期内容是我对自己经常使用的免费ai工具做一个分享。本分享只分享ai工具自带的免费额度,不分享api,因为api经常不稳定,限速,很多制度不透明。以后打算每次这几个平台有更新,或者有新的平台出现,我会接着出第二期,第三期等。
这篇文章是我自己实测使用记录整理出来,五款平台的免费积分规则、每月能白嫖多少、免费模型怎么选,都分享给大家,基于自己的经验分享,不一定百分百准确,有不准的也希望大家指正。本次分享时间有效期2026年9月,因为ai工具不断争用户,活动一直在变。有更新我会及时同步。
免费额度积分
平台免费额度积分基本是这三种方式来的:
- 注册或邀请赠送:一次性到账,通常 30 天左右有效,是新人第一个月的大头。
- 每月登录:每月固定送一笔,当月有效,下月刷新。
- 每日签到:每天一点,有效期跟随活动走,一般是 30 多天。
这些积分都有有效期,如果每月能领的积分或者当日积分都能用完,那么实际能最大使用的积分如下图。下面这张图是我按 2026 年 9 月实测整理的各平台对比。如果有新的好用的平台,欢迎大家推荐。
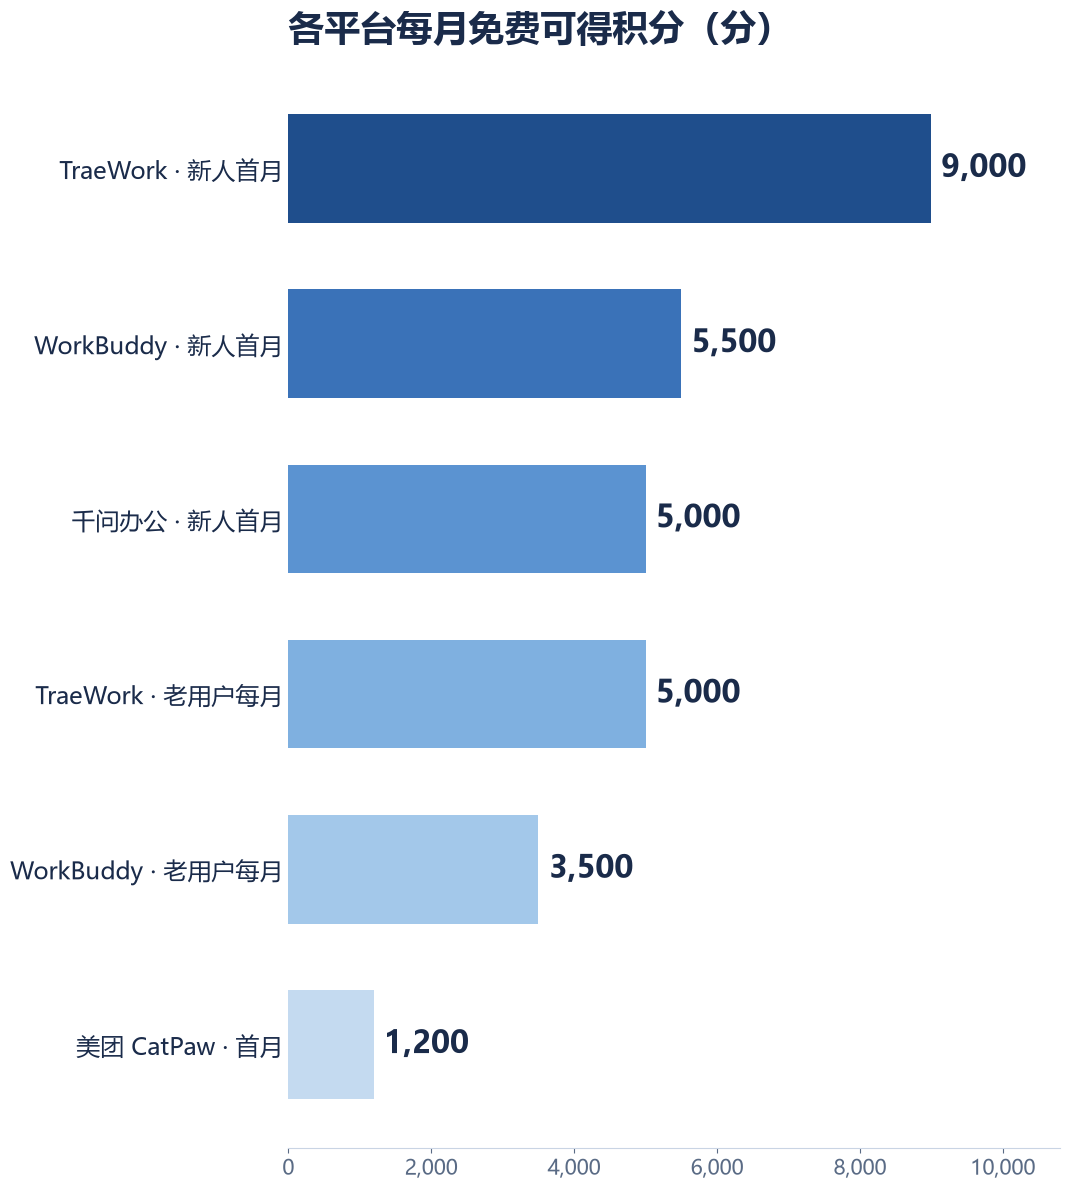
五款平台横向对比总览:
| 平台 | 注册/邀请赠送 | 每月登录 | 每日签到 | 新人首月 | 老用户每月 | 最经济模型 |
|---|---|---|---|---|---|---|
| TraeWork | 2000 通用 + 2000 Work(31 天) | 500 | 150(约 31 天) | 约 9000 | 约 5000 | Seed-Code(多模态)、Deepseek-V4-Flash 正式版(文本) |
| WorkBuddy | 2000(30 天) | 500 | 100(30 多天) | 约 5500 | 约 3500 | GLM-5.3-Flash(多模态)、Deepseek-V4-Flash(文本) |
| 千问办公 | 2000(90 天,据公开信息) | — | 100(当天有效) | 约 5000 | 每日 100 | 标准模式 0.1X 倍率,极耐用 |
| 美团 CatPaw | 1000 | 200 | 无签到 | 1200(次月起每月 200) | 200 | LongCat-2.0(免费) |
| OpenCode | 免费模型,无限额但有限速 | — | — | — | — | 见下方模型排名 |
WorkBuddy:新人一个月 5500 分
WorkBuddy 走邀请链接注册送 2000 积分,按注册之日起 30 天内有效;每月登录送 500 积分,当月有效;每日签到 100 积分,一般跟活动走,有效期30 多天。
老用户没有注册礼,靠登录加签到,每月有约 3500 积分。
WorkBuddy 官方一个月 4000 积分的套餐卖 99 元。按这个单价折算,5500 积分约等于每月 136 元。也就是说,新用户头一个月白拿的额度,比一个付费套餐还多;老用户每月也有约 87 元。
模型方面,免费档是 hy3 和 Hy4 preview。想省着用,除免费模型外,多模态建议选 GLM-5.3-Flash,纯文本选 Deepseek-V4-Flash,这两款是目前性价比最高的。
TraeWork :新人首月 9000 分
TraeWork 是字节系 AI 原生 IDE Trae 在 2026 年 7 月上线积分体系后推出的 Work 模式玩法,免费额度给得最足。走邀请链接注册,一次性送 2000 通用积分和 2000 Work 专属积分,31 个自然日有效;每月登录送 500 积分,当月有效;每日签到 150 通用积分,一般跟活动走 31 天。
新人首月约 9000 积分,老用户每月约 5000 积分,五家里排第一。
模型上:多模态用 Seed-Code(注意它只在 Code 模式下显示),文本用 Deepseek-V4-Flash 正式版,最省钱。
千问办公:注册赠送 2000 积分
千问办公注册赠送 2000 积分(据公开信息有效期 90 天),每日登陆给 100 积分,当天有效。
标准模式按 0.1X 倍率消耗(使用模型是qwen3.8flash),非常耐用。按官方公开测算,1000 积分大约能完成 322 份 Word、556 份 PDF、100 份 PPT、45 份 Excel 或 119 份 HTML 报告。
如果你主要是文档处理、报告生成这类办公场景,千问办公的积分是最经花的。
OpenCode:有免费模型
OpenCode 有免费模型,但有速率限制,而且官方没有公布限制细则。
它的开发公司是 Anomaly Innovations(GitHub 上叫 anomalyco),总部在加拿大多伦多,软件面向全球用户,所以限速策略和地区相关。
我自己用下来,偶尔会碰到限速变慢,换个时间段或者换个地区网络节点,通常就缓过来了。当补充额度用,很合适。
OpenCode 免费模型
OpenCode 免费档可用的模型有 Muse Spark 1.3 Contributor、Nemotron 3 Ultra、MiMo-V2.5、Nemotron 3.5 Lightning、Ling 3.0 Flash Fin,另有一个匿名代号 Big Pickle(底层模型不确定)。排名整理如下:
| 排名 | 模型 | 判断 |
|---|---|---|
| 1 | Muse Spark 1.3 Contributor | 上限最高;如果免费端调用的是完整 1.3,只是 Contributor 数据条款/额度不同,它应是这组最强 |
| 2 | Nemotron 3 Ultra | 深度推理、代码审查、长任务强;但速度和免费端稳定性可能不如 Muse |
| 3 | MiMo-V2.5 | 多模态、长上下文、日常 Agent 很强;但注意不要把 MiMo-V2.5-Pro 的编程成绩直接套过来 |
| 4 | Nemotron 3.5 Lightning | 速度和批量执行优秀,适合简单修改、测试、工具调用;复杂工程明显低于 Ultra |
| 5 | Ling 3.0 Flash Fin | 金融、表格、财务代码可用;通用软件工程不建议优先 |
| 不排名 | Big Pickle | 匿名代号,底层模型可能变化,没有稳定模型身份和公开编程基准 |
美团 CatPaw:注册送 1000,每月再送 200
美团在 2026 年 7 月上线了全场景 AI Agent 平台 CatPaw。注册送 1000 积分,每月再给 200 积分,没有签到。
免费模型是 LongCat-2.0。每月 200 积分加上免费模型,轻度使用够了;它的强项是结合美团内部能力的日常办公和业务协作。
模型怎么选
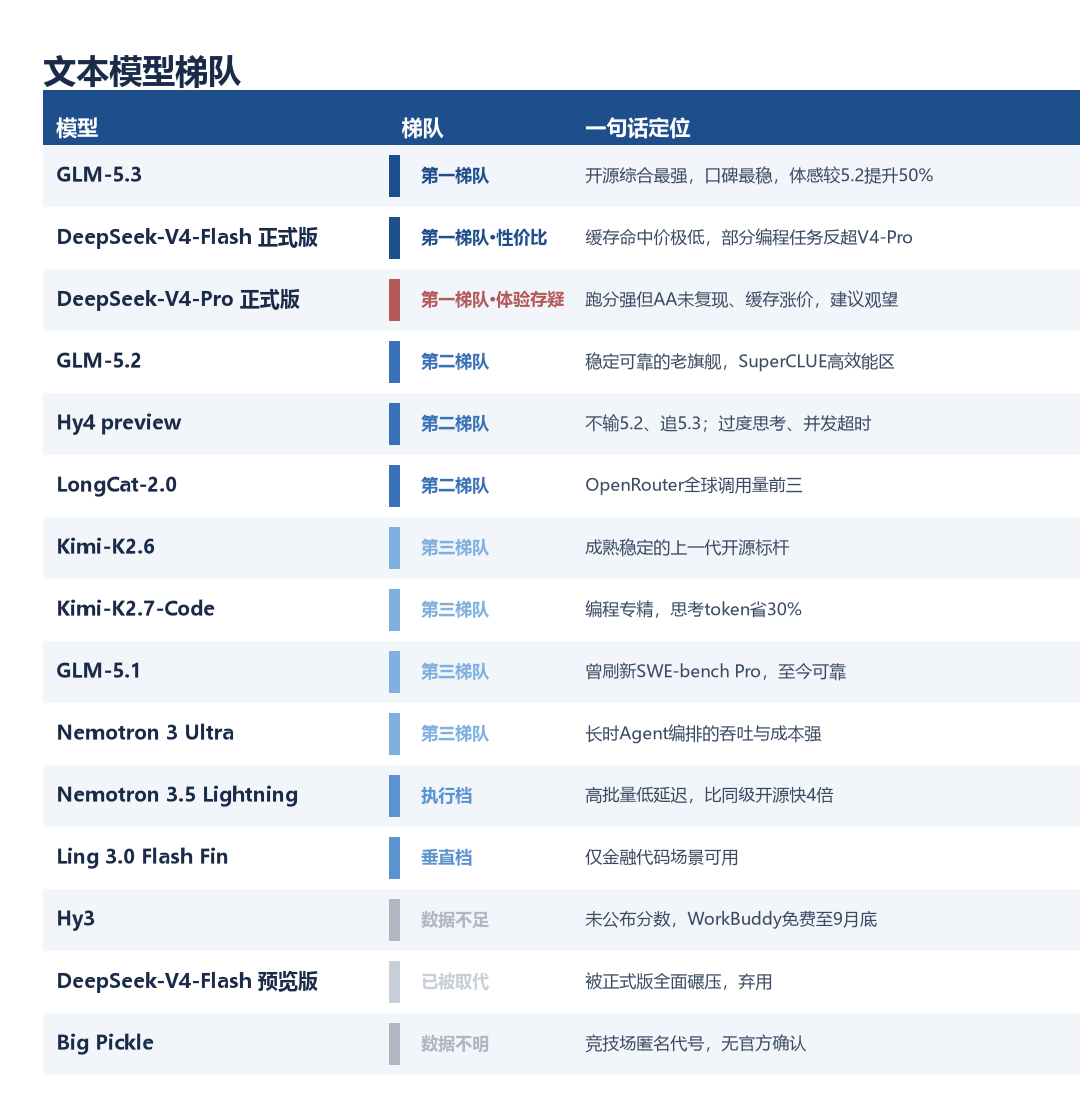
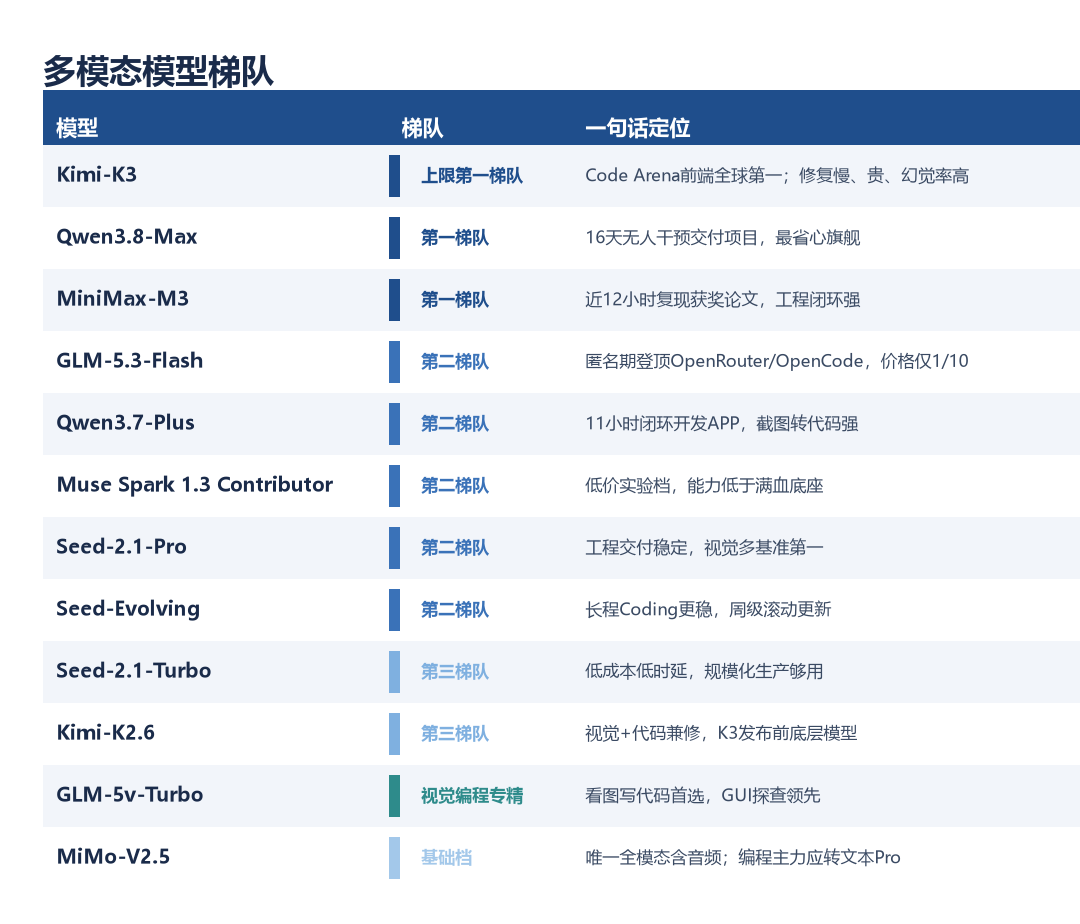
排名整理自公开跑分和实测口碑,分文本模型、多模态模型、编程综合能力、图片处理能力四张表,按梯队从高到低排,每个模型附一句话定位。
文本模型
| 模型 | 梯队 | 跑分依据 | 实际体验口碑 |
|---|---|---|---|
| GLM-5.3 | 第一梯队 | Terminal-Bench 3.0 得 28.3 开源最佳、DeepSWE v1.1 66.9、Z.ai Code Bench High 档 31.4% 超 Opus 4.8 且 token 仅其 42% | 实测口碑最稳的开源一哥:体感较 5.2 提升 50%,token 效率实测占优,ZCode 实测顺畅 |
| DeepSeek-V4-Flash 正式版 | 第一梯队(性价比) | Terminal-Bench 2.1 得 82.7(超 GLM-5.2)、DeepSWE 7.3→54.4、AA 智能指数 52 | 性价比之王:缓存命中价极低,官方自认部分编程任务反超 V4-Pro |
| DeepSeek-V4-Pro 正式版 | 官方跑分第一梯队/体验存疑 | Terminal-Bench 2.1 得 87.9(距 Fable 5 仅 0.1)、DeepSWE 62.7、CyberGym 83.3 | 体验翻车:AA 仅 53 分未复现官方数据、Codex 实测 4100 万 tokens 后不推荐、前端远低预期、对官方 Harness 过拟合、缓存涨价最高 11 倍,建议观望 |
| GLM-5.2 | 第二梯队 | Terminal-Bench 2.1 得 81.0、SWE-bench Pro 62.1、FrontierSWE 仅落后 Opus 4.8 约 1%、Code Arena 全球可用模型第一 | 稳定可靠的老旗舰,SuperCLUE 评定处于"高效能区"(快且好) |
| Hy4 preview | 第二梯队 | DeepSWE 28.0→64.3、Code Arena WebDev 榜第 5(开源第 3)、腾讯内部盲测 2.99/4 略高于 GLM-5.3 与 K3 | 实测"不输 GLM-5.2、追 GLM-5.3";硬伤:过度思考(一题想半小时)、并发超时、价格偏高 |
| LongCat-2.0 | 第二梯队 | SWE-bench Pro 59.5%,专为真实 Agentic Coding 设计 | OpenRouter 全球调用量前三,是开发者的用脚投票 |
| Kimi-K2.6 | 第三梯队 | SWE-bench Verified 80.2%、LiveCodeBench 89.6%、自主编码 13 小时、300 子 Agent 蜂群 | 成熟稳定的上一代开源标杆,被 SuperCLUE-XClaw 用于 KimiClaw 产品 |
| Kimi-K2.7-Code | 第三梯队 | Kimi Code Bench v2 较 K2.6 提升 21.8% 至 62.0、思考 token 省 30% | 编程专精但绝对水平仍低于 GPT-5.5/Opus 4.8 同表成绩 |
| GLM-5.1 | 第三梯队 | 曾刷新 SWE-bench Pro 全球最佳、首超 Opus 4.6、8 小时长程任务 | 5 月中文汇总 84.2 分,至今仍是可靠选择 |
| Nemotron 3 Ultra | 第三梯队 | PinchBench 91%、Terminal-Bench 2.0 领先、吞吐较 GLM-5.1-754B 高至 5.9 倍 | 强项是长时 Agent 编排的吞吐与成本,非单项登顶 |
| Nemotron 3.5 Lightning | 执行档 | 30B-A3B 紧凑 MoE,为高批量低延迟调用优化 | 比同级开源快至 4 倍,适合大规模执行/验证/工具调用 |
| Ling 3.0 Flash Fin | 垂直档 | 金融智能体基准(SpreadsheetBench、Finance Agent 等)有竞争力 | 仅金融代码场景可用,通用智能指数 41,不适合通用编程 |
| Hy3 | 数据不足 | 官方称"代码能力大幅提升",未公布具体分数 | SuperCLUE 评定处于高效能区,WorkBuddy 免费至 9 月底 |
| DeepSeek-V4-Flash 预览版 | 已被取代 | Terminal-Bench 61.8、DeepSWE 7.3 | 被 0731 正式版全面碾压,不再建议使用 |
| Big Pickle | 数据不明 | 竞技场匿名代号 | 仅网友推测为 MiniMax M2.5 别名(若属实对应 SWE-bench Verified 80.2),无官方确认 |
多模态模型
| 模型 | 梯队 | 跑分依据 | 实际体验口碑 |
|---|---|---|---|
| Kimi-K3 | 上限第一梯队 | Code Arena 前端 1679 分全球第一(超 Fable 5)、Terminal-Bench 2.1 得 88.3 | 体验分层:深度编程/长文档极强,但修复耗时是竞品 3.4 倍(12 分钟 vs 3.5 分钟)、贵(输出 100 元/M)、幻觉率 51%,日常轻任务不推荐 |
| Qwen3.8-Max | 第一梯队 | Frontend Code Arena 第 4、Text Arena 第 5、自主完成 16 天真实软件工程 | 16 天无人干预交付项目+幻觉控制断层领先,综合最省心的旗舰 |
| MiniMax-M3 | 第一梯队 | SWE-Bench Pro 59.0% 超 GPT-5.5 与 Gemini 3.1 Pro、接近 Opus 4.7 | 自主运行近 12 小时复现获奖论文,工程闭环能力强 |
| GLM-5.3-Flash | 第二梯队 | AA 智能指数 57 与 Opus 4.8 持平、全面超 GLM-5.2 | 匿名测试期(Ox-Alpha"牛来")登顶 OpenRouter/OpenCode 创纪录,价格仅 GLM-5.3 的 1/10,性价比极高 |
| Qwen3.7-Plus | 第二梯队 | Terminal Bench/SciCode 较上代提升约 9 分、媲美 Opus 4.6-Max | 11 小时自主闭环开发真实 APP,截图转代码能力强 |
| Muse Spark 1.3 Contributor | 第二梯队 | 底座 1.3 官方称编码超 GPT-5.6 Sol、AA 智能指数 62 | 工具调用减 20%、token 省 25%;Contributor 为低价实验档(输入 $0.10/M) |
| Seed-2.1-Pro | 第二梯队 | TerminalBench 2.1 得 71.0、SciCode 59.8、Code Arena 1539 分第 8 | 工程交付稳定,AiPy 测评联网/HTML 任务成功率全球第 5-6 |
| Seed-Evolving | 第二梯队 | 滚动映射 Seed-2.1-Pro 水平 | 实测长程 Coding 质量比 2.1-Pro 更稳、仓库理解与受控修复更好 |
| Seed-2.1-Turbo | 第三梯队 | 官方称效果比肩 Pro、低成本低时延 | 面向规模化生产场景,单任务深度不如 Pro |
| Kimi-K2.6 | 第三梯队 | SWE-bench Verified 80.2%、内置 MoonViT | 视觉+代码兼修,K3 发布前是 KimiClaw 底层模型 |
| GLM-5v-Turbo | 视觉编程专精 | 设计稿还原/视觉代码生成/GUI 探查基准领先 | 看图写代码专精选手,纯文本编程经 RL 保障不退化 |
| MiMo-V2.5 | 基础档 | 官方称日常 Agent 任务比肩 V2.5-Pro | 编程主力应转其文本版 Pro(SWE-bench Pro 57.2、GDPVal-AA 1581 开源第一) |
编程综合能力
| 模型 | 类型 | 综合梯队 | 跑分依据 | 实际体验口碑 |
|---|---|---|---|---|
| Kimi-K3 | 多模态 | 第一梯队·上限最高 | Code Arena 前端 1679 分全球第一(超 Fable 5)、Terminal-Bench 2.1 得 88.3 | 深度编程/长文档极强;但修复耗时是竞品 3.4 倍、幻觉率 51%、输出 100 元/M,日常轻任务不推荐 |
| GLM-5.3 | 纯文本 | 第一梯队·开源综合最强 | Terminal-Bench 3.0 得 28.3 开源最佳、DeepSWE v1.1 66.9、Code Bench 31.4% 超 Opus 4.8 且 token 仅其 42% | 实测口碑最稳:体感较 5.2 提升 50%,token 效率占优,ZCode 实测顺畅 |
| Qwen3.8-Max | 多模态 | 第一梯队·最省心旗舰 | Frontend Code Arena 第 4、Text Arena 第 5 | 自主完成 16 天真实软件工程,幻觉控制断层领先 |
| DeepSeek-V4-Flash 正式版 | 纯文本 | 第一梯队·性价比之王 | Terminal-Bench 2.1 得 82.7、DeepSWE 7.3→54.4、AA 智能指数 52 | 缓存命中成本极低,官方自认部分编程任务反超 V4-Pro |
| DeepSeek-V4-Pro 正式版 | 纯文本 | 第一梯队⚠️跑分强/体验存疑 | Terminal-Bench 2.1 得 87.9(距 Fable 5 仅 0.1)、DeepSWE 62.7、CyberGym 83.3 | AA 仅 53 分未复现官方数据、Codex 实测 4100 万 tokens 后不推荐、Harness 过拟合、缓存涨价最高 11 倍,建议观望 |
| MiniMax-M3 | 多模态 | 第一梯队 | SWE-Bench Pro 59.0% 超 GPT-5.5 与 Gemini 3.1 Pro、接近 Opus 4.7 | 自主运行近 12 小时复现获奖论文,工程闭环能力强 |
| GLM-5.2 | 纯文本 | 第二梯队 | Terminal-Bench 2.1 得 81.0、SWE-bench Pro 62.1、FrontierSWE 仅差 Opus 4.8 约 1% | 稳定老旗舰,SuperCLUE 高效能区(快且好) |
| GLM-5.3-Flash | 多模态 | 第二梯队·多模态性价比 | AA 智能指数 57 与 Opus 4.8 持平、官方称全面超 GLM-5.2 | 匿名期 Ox-Alpha 登顶 OpenRouter/OpenCode 创纪录,价格仅 GLM-5.3 的 1/10 |
| Hy4 preview | 纯文本 | 第二梯队 | DeepSWE 28.0→64.3、Code Arena WebDev 第 5(开源第 3)、内部盲测 2.99/4 | 实测"不输 5.2、追 5.3";硬伤:过度思考(一题想半小时)、并发偶发超时 |
| Qwen3.7-Plus | 多模态 | 第二梯队 | Terminal Bench/SciCode 较上代 +9 分、媲美 Opus 4.6-Max | 11 小时自主闭环开发真实 APP,截图转代码强 |
| Seed-Evolving | 多模态 | 第二梯队 | ≈Seed-2.1-Pro 水平,周级滚动更新 | 实测长程 Coding 比 2.1-Pro 更稳、仓库理解与受控修复更好 |
| Seed-2.1-Pro | 多模态 | 第二梯队 | TerminalBench 2.1 得 71.0、SciCode 59.8、Code Arena 1539 分第 8 | 工程交付稳定,联网/HTML 任务成功率全球第 5-6 |
| LongCat-2.0 | 纯文本 | 第二梯队 | SWE-bench Pro 59.5%,专为真实 Agentic Coding 设计 | OpenRouter 全球调用量前三,开发者的用脚投票 |
| Kimi-K2.6 | 多模态 | 第三梯队 | SWE-bench Verified 80.2%、LiveCodeBench 89.6% | 成熟稳定的上一代开源标杆,自主编码 13 小时、300 子 Agent 蜂群 |
| Kimi-K2.7-Code | 纯文本 | 第三梯队 | Kimi Code Bench v2 较 K2.6 提升 21.8% 至 62.0、思考 token 省 30% | 编程特化,绝对水平仍低于 GPT-5.5/Opus 4.8 同表成绩 |
| GLM-5.1 | 纯文本 | 第三梯队 | 曾刷新 SWE-bench Pro 全球最佳、首超 Opus 4.6 | 8 小时长程任务,验证充分的老旗舰 |
| Seed-2.1-Turbo | 多模态 | 第三梯队 | 官方称效果比肩 Pro、低成本低时延 | 规模化生产场景够用,单任务深度不如 Pro |
| GLM-5v-Turbo | 多模态 | 第三梯队·视觉编程专精 | 设计稿还原/视觉代码生成/GUI 探查基准领先 | 看图写代码专精,纯文本编程经 RL 保障不退化 |
| Muse Spark 1.3 Contributor | 多模态 | 第二梯队 | 底座 1.3 编码超 GPT-5.6 Sol、AA 智能指数 62 | 工具调用-20%、token 省 25%;Contributor 为低价实验档($0.10/M 输入),实际能力低于底座满血版 |
| Nemotron 3 Ultra | 纯文本 | 第三梯队 | PinchBench 91%、吞吐较 GLM-5.1-754B 高至 5.9 倍、成本-30% | 强在长时 Agent 编排的吞吐与成本,非单项登顶 |
| MiMo-V2.5 | 多模态 | 第三梯队·基础档 | 官方称日常 Agent 任务比肩 V2.5-Pro | 编程主力是其文本版 MiMo-V2.5-Pro(SWE-bench Pro 57.2、GDPVal-AA 1581 开源第一,未在本清单内) |
| Nemotron 3.5 Lightning | 纯文本 | 执行档 | 30B-A3B 紧凑 MoE,高批量低延迟优化 | 比同级开源快至 4 倍,适合大规模执行/验证/工具调用 |
| Ling 3.0 Flash Fin | 纯文本 | 金融垂直档 | SpreadsheetBench、Finance Agent 等金融基准有竞争力 | 通用智能指数仅 41,仅金融代码场景可用 |
| Hy3 | 纯文本 | 数据不足 | 官方称"代码能力大幅提升"未公布分数 | SuperCLUE 高效能区,WorkBuddy 免费至 9 月底 |
| DeepSeek-V4-Flash 预览版 | 纯文本 | 已被取代 | Terminal-Bench 61.8、DeepSWE 7.3 | 被 0731 正式版全面碾压,弃用 |
| DeepSeek-V4-Pro 预览版 | 纯文本 | 已被取代 | Terminal-Bench 72.1、DeepSWE 12.8 | 被 0813 正式版代际超越 |
| Big Pickle | 纯文本 | 数据不明 | 竞技场匿名代号,无跑分 | 仅网友推测为 MiniMax M2.5 别名(若属实对应 SWE-bench Verified 80.2),无官方确认 |
图片处理能力
| 模型 | 图片输入 | 视觉水平定位 | 依据/数据 |
|---|---|---|---|
| Kimi-K3 | ✅ 原生视觉 | 视力顶级但慢 | SVG 细节实测超 Fable 5、水波纹物理连贯;但复杂图表偏 OCR+推理,生成时间 2-3 倍 |
| Qwen3.8-Max | ✅ | 视觉第一梯队 | Vision Arena 全球第 2,教育解题/视频理解/三维创作全流程视觉生产力 |
| Seed-2.1-Pro | ✅ 图+视频 | 视觉第一梯队 | CharXiv-RQ、MeasureBench 等多项基准最高分,ERQA 空间理解最佳,TVBench/VideoMME 业界高分 |
| Seed-Evolving | ✅ 图+视频+文档 | 视觉第一梯队 | 继承 2.1 系视觉能力,周级滚动增强图像理解/图文推理/视觉风险识别 |
| Qwen3.7-Plus | ✅ 图+视频 | 视觉第一梯队 | 曾推动阿里进 Vision Arena 全球前五/中国第一,截图转代码、高级 OCR |
| GLM-5.3-Flash | ✅ 图+视频+文件 | 第二梯队 | 原生多模态,视觉编入编程闭环(观察界面→改进代码),处理 PPTX/PDF/DOCX/XLSX 版面 |
| MiniMax-M3 | ✅ 图+视频 | 第二梯队 | OmniDocBench 超 Gemini 3.1 Pro,可操作电脑桌面 |
| GLM-5v-Turbo | ✅ 图+视频+文件 | 视觉编程专精 | 设计稿还原/视觉代码生成/GUI 探查基准领先,“看图写代码"首选 |
| MiMo-V2.5 | ✅ 图+视频+音频 | 第二梯队 | 27 个模型中唯一全模态(含音频),长视频追踪与跨模态长程推理 |
| Muse Spark 1.3 Contributor | ✅ 图+视频+PDF+音频 | 第二梯队 | 底座支持图像/视频/PDF/音频,1M 上下文 |
| Kimi-K2.6 | ✅ 图+视频 | 第三梯队 | 内置 MoonViT 编码器,可用但非主打 |
| Seed-2.1-Turbo | ✅ 图+视频 | 第三梯队 | 保留图/视频输入,档位低于 Pro |
日常多模态办公选 GLM-5.3-Flash,纯文本编程主力选 GLM-5.3 或 DeepSeek-V4-Flash 正式版,要上限和长程任务上 Kimi-K3 或 Qwen3.8-Max。排名数据整理自公开跑分与实测口碑,具体以各平台当前页面为准。
经验分享
- 中度使用:上面五款任意挑一两款主力,免费积分完全够用,不用花钱。
- 重度使用:多台设备加家人或者朋友的手机号分开注册,互相走邀请链接,双方都拿积分,再各自登录签到。
我现在是三台电脑每天签到,重度使用(编程和自媒体文字创作)完全覆盖,积分根本用不完。
积分规则和模型列表会随平台活动调整,文中数据基于 2026 年 9 月的实测与公开信息,具体以各平台当前页面为准。
💬 评论